Funktionsweise, Einsatzgebiete und Unterschiede zum Forward-Proxy

Ein Reverse-Proxy ist ein Server, der Anfragen von Clients stellvertretend für einen oder mehrere Backend-Server entgegennimmt, an den passenden Server weiterleitet und dessen Antwort an den Client zurückgibt. Für Nutzerinnen und Nutzer wirkt der Reverse-Proxy wie der eigentliche Webserver. Eingesetzt wird er vor allem, um Server abzusichern, Last zu verteilen und Websites durch Caching, Kompression und TLS-Terminierung schneller und effizienter auszuliefern.
Wie funktioniert ein Reverse-Proxy?
Grundsätzlich fungiert ein Proxy-Server als Vermittler im Netzwerk: Er nimmt Anfragen entgegen und leitet sie stellvertretend an ein Ziel weiter. Ein Reverse-Proxy steht dabei zwischen den Clients (z. B. Webbrowsern oder Apps) und den Backend-Servern (z. B. Webservern oder Anwendungsservern). Clients kommunizieren ausschließlich mit dem Reverse-Proxy; welche internen Server die Anfrage tatsächlich bearbeiten, bleibt für sie unsichtbar. Der Ablauf umfasst vier grundlegende Schritte:
- Empfang der Client-Anfrage: Der Reverse-Proxy nimmt Anfragen über HTTP bzw. HTTPS entgegen, heute meist in den Protokollversionen HTTP/1.1, HTTP/2 oder HTTP/3, sowie langlebige Verbindungen wie WebSocket. Je nach Software lassen sich auch andere Dienste auf TCP- oder UDP-Ebene weiterleiten, etwa FTP.
- Analyse der Anfrage: Der Proxy prüft, ob die Anfrage gültig und zulässig ist, ob sie Sicherheitsregeln verletzt und ob eine zwischengespeicherte Antwort vorliegt. Anhand von Hostname, Pfad oder Headern entscheidet er, welches Backend zuständig ist.
- Weiterleitung an den passenden Server: Kann die Anfrage nicht aus dem Cache beantwortet werden, sendet der Reverse-Proxy sie an einen der internen Server. Dabei ergänzt er in der Regel Header mit Informationen über den ursprünglichen Client (mehr dazu im Abschnitt „Weitergabe der Client-Informationen“).
- Antwort an den Client: Der Reverse-Proxy empfängt die Antwort des Backend-Servers, verarbeitet sie bei Bedarf weiter (z. B. Kompression, Verschlüsselung, Zwischenspeicherung) und sendet sie an den anfragenden Client zurück.

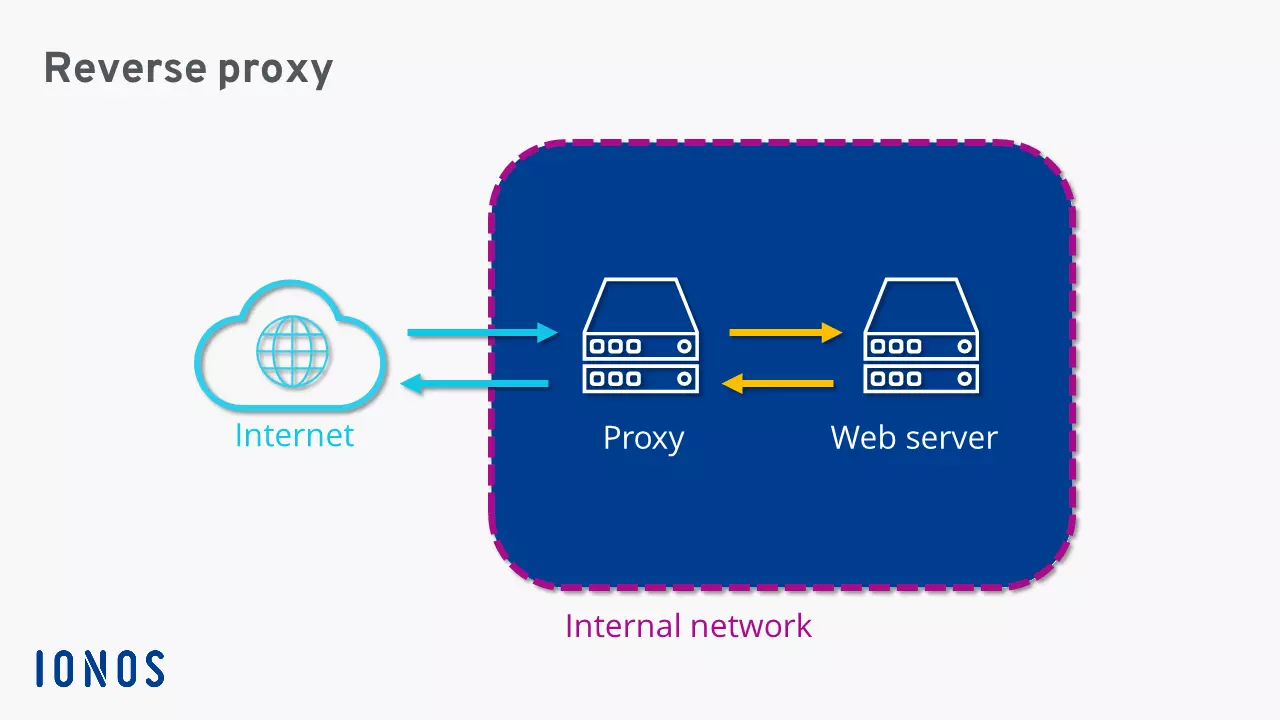
Reverse-Proxys werden in der Regel von einer Firewall abgesichert in einem privaten Netzwerk oder einer vorgelagerten demilitarisierten Zone (DMZ) installiert. Die Backend-Server selbst sind dann nicht direkt aus dem Internet erreichbar.
Was ist der Unterschied zwischen Forward-Proxy und Reverse-Proxy?
Beide Proxy-Arten vermitteln zwischen Clients und Servern, sie handeln aber im Auftrag unterschiedlicher Seiten:
- Ein Forward-Proxy handelt im Auftrag der Clients. Er sitzt zwischen den Geräten in einem internen Netzwerk und dem Internet, bündelt deren ausgehende Anfragen und leitet sie mit der eigenen Absenderadresse an die Zielserver weiter. Die Zielserver sehen daher nur die Adresse des Proxys, nicht die der einzelnen Clients – es sei denn, es handelt sich um einen transparenten Proxy, der die Client-Adresse nicht verbirgt.
- Ein Reverse-Proxy handelt im Auftrag der Server. Er nimmt eingehende Anfragen aus dem Internet entgegen und verteilt sie an Server, die meist in einem privaten Netzwerk stehen. Er macht diese Server kontrolliert öffentlich erreichbar, schützt sie und optimiert ihre Auslieferung.
Vereinfacht gesagt: Der Forward-Proxy schützt und steuert Clients, der Reverse-Proxy schützt und entlastet Server.
| Merkmal | Forward-Proxy | Reverse-Proxy |
|---|---|---|
| Handelt im Auftrag von | Clients | Servern |
| Position | zwischen internem Client-Netz und Internet | zwischen Internet und Backend-Servern |
| Wer kennt den Proxy? | Clients sind für ihn konfiguriert (außer bei transparenten Proxys) | Clients merken nichts davon, sie sprechen ihn wie den eigentlichen Server an |
| Verbirgt | die Clients gegenüber den Zielservern | die Backend-Server gegenüber den Clients |
| Typische Funktionen | Zugriffskontrolle, Inhaltsfilter, Caching für Clients | Load Balancing, Caching, TLS-Terminierung, WAF |
| Typischer Einsatz | Unternehmensnetzwerke, Schulen, Behörden | Websites, Webanwendungen, APIs |
| Betrieben von | Organisation der Nutzerinnen und Nutzer | Betreiber des Onlinedienstes |

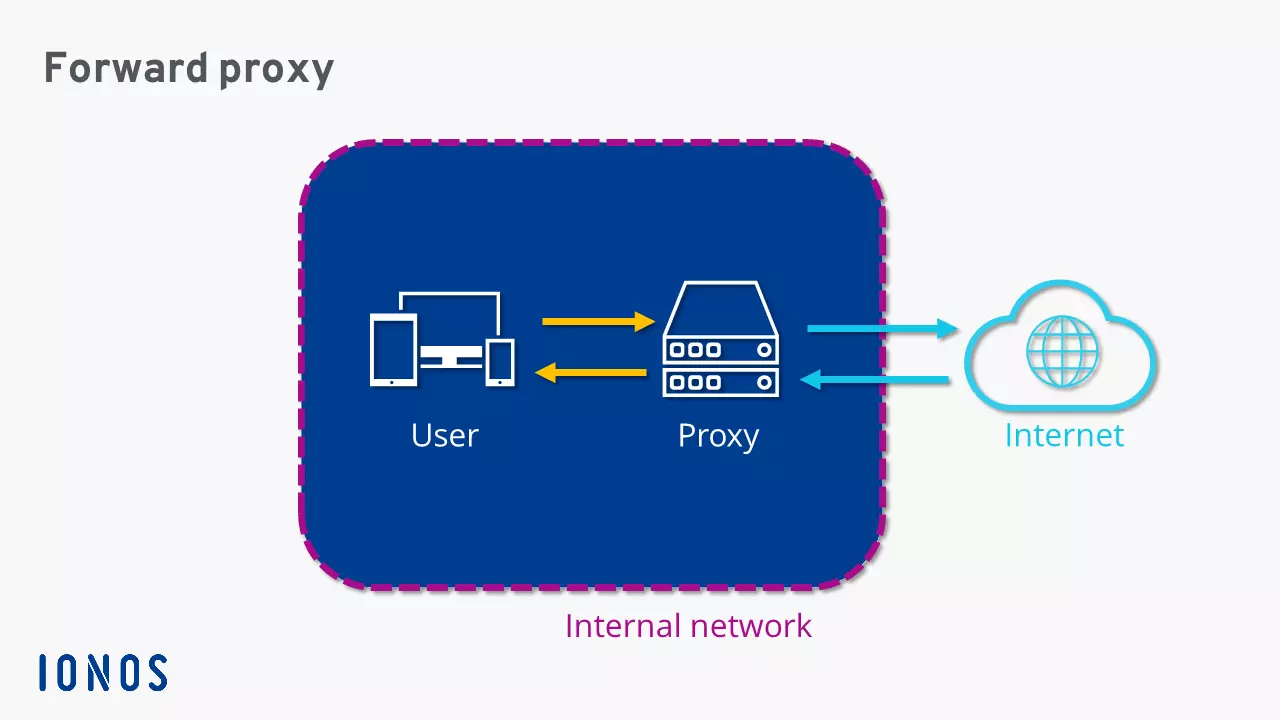
Forward-Proxys werden häufig eingesetzt, um den Internetzugriff in Unternehmensnetzwerken zu kontrollieren und zu filtern. Auch zur Umgehung von Geo-Blockaden kommen sie zum Einsatz. Ein VPN verfolgt ähnliche Ziele, funktioniert aber anders: Es baut einen verschlüsselten Tunnel auf und leitet in der Regel den gesamten Datenverkehr eines Geräts um, während ein Proxy nur einzelne Anwendungen oder Protokolle vermittelt.
Reverse-Proxy: Anwendungsgebiete
Weil alle Anfragen über den Reverse-Proxy laufen, lässt sich der eingehende Datenverkehr an einer zentralen Stelle steuern. So lassen sich mehrere Server oder Anwendungen unter derselben Domain bereitstellen, Anfragen auf verschiedene Server verteilen, Inhalte zwischenspeichern und Sicherheitsregeln einheitlich durchsetzen. Die folgenden Einsatzfelder sind die wichtigsten.
- Kostengünstige vCPUs und leistungsstarke dedizierte Cores
- Höchste Flexibilität ohne Mindestvertragslaufzeit
- Inklusive 24/7 Experten-Support
Load Balancing
Über einen vorgeschalteten Reverse-Proxy lässt sich eine Domain mit mehreren Servern im privaten Netzwerk verknüpfen. Eingehende Anfragen werden dann nach einem festgelegten Verfahren verteilt, etwa reihum (Round Robin), an den Server mit den wenigsten aktiven Verbindungen (Least Connections) oder anhand der Client-IP (IP-Hash), damit ein Client immer beim selben Server landet. Ein solches Load Balancing beugt der Überlastung einzelner Systeme vor. Über regelmäßige Health Checks erkennt der Proxy, wenn ein Server aufgrund von Hardware- oder Softwarefehlern nicht antwortet, und verteilt die Anfragen auf die verbleibenden Server. So bleibt der Dienst auch bei Ausfällen verfügbar, und einzelne Server lassen sich für Wartungsarbeiten aus dem Betrieb nehmen, ohne dass Nutzerinnen und Nutzer etwas davon bemerken.
Caching
Viele Reverse-Proxys können häufig abgerufene Inhalte zwischenspeichern und wiederkehrende Anfragen ganz oder teilweise selbst beantworten. Das betrifft vor allem statische Inhalte wie Bilder, JavaScript-Dateien oder CSS-Stylesheets. Da weniger Anfragen beim Backend-Server ankommen, sinken Antwortzeiten und Serverlast spürbar.
Wie lange eine Antwort im Cache bleiben darf, steuern Betreiber über HTTP-Header wie Cache-Control oder über eigene Regeln im Proxy. Bei Inhalten, die sich häufig ändern, besteht das Risiko, dass Clients veraltete Versionen erhalten. Viele Lösungen erlauben es daher, einzelne Einträge oder den gesamten Cache gezielt zu leeren, etwa nach einem Update der Website. Besondere Vorsicht ist bei personalisierten Inhalten geboten: Werden Seiten mit Nutzerdaten versehentlich zwischengespeichert, können sie anderen Besucherinnen und Besuchern angezeigt werden.
Schutz- und Sicherheitsmaßnahmen
Ein Reverse-Proxy fungiert als Schutzschild für die Backend-Server und kann in dieser Rolle verschiedene Sicherheitsfunktionen übernehmen:
- DDoS-Abwehr und Rate Limiting: Reverse-Proxys können auffällige oder ungewöhnlich hohe Anfragemengen, wie sie bei DDoS-Angriffen auftreten, erkennen, die Zahl der Anfragen pro Client begrenzen und solchen Traffic blockieren, bevor er die Backend-Server erreicht. Gegen große volumetrische Angriffe, die bereits die Netzanbindung überlasten, reicht ein einzelner Proxy allerdings nicht aus; dafür sind verteilte Schutzdienste des Hosting- oder CDN-Anbieters nötig.
- Web Application Firewall (WAF): Viele Reverse-Proxys lassen sich um eine WAF ergänzen oder bringen eine mit. Sie filtert schädliche Anfragen wie SQL-Injections oder Cross-Site-Scripting (XSS). Bei NGINX und Apache geschieht das meist über Zusatzmodule wie ModSecurity.
- Allowlists und Blocklists: Der Proxy kann bestimmte IP-Adressen oder Netzbereiche sperren oder Verbindungen nur aus festgelegten Netzwerken zulassen, etwa für Administrationsbereiche.
- Zentrale Authentifizierung: Anmeldungen, etwa per Single Sign-on, lassen sich am Proxy bündeln, statt sie in jeder Anwendung einzeln umzusetzen.
- Verschleierung der Backend-Server: Da Clients nur mit dem Proxy kommunizieren, bleiben die internen IP-Adressen und die Struktur der Backend-Server verborgen. Das erschwert gezielte Angriffe auf einzelne Systeme.
Verschlüsselung und TLS-Terminierung
Reverse-Proxys übernehmen häufig die Verschlüsselung für alle dahinterliegenden Dienste. Bei der sogenannten TLS-Terminierung baut der Proxy die verschlüsselte SSL/TLS-Verbindung zum Client auf, entschlüsselt die Anfrage, leitet sie an den Backend-Server weiter und sendet die Antwort wieder verschlüsselt an den Client zurück. Zertifikate müssen so nur an einer Stelle verwaltet werden, und die Backend-Server werden von der rechenintensiven Verschlüsselung entlastet. Aktuelle Standards wie TLS 1.3 oder HTTP/3, das auf dem Transportprotokoll QUIC basiert, lassen sich auf diese Weise zentral für alle Dienste aktivieren, auch wenn die Anwendungen dahinter sie selbst nicht unterstützen.
Die interne Verbindung zwischen Proxy und Backend kann unverschlüsselt erfolgen, wenn das interne Netz vertrauenswürdig ist. In sensiblen Umgebungen oder bei geteilter Infrastruktur verschlüsselt der Proxy auch diese Strecke erneut (Re-Encryption) oder reicht die verschlüsselte Verbindung unverändert durch (TLS-Passthrough).
Viele Reverse-Proxys können TLS-Zertifikate zudem automatisch über das ACME-Protokoll beziehen und erneuern, etwa bei der kostenlosen Zertifizierungsstelle Let’s Encrypt. Caddy erledigt das standardmäßig, Traefik bringt die Funktion mit und benötigt nur wenige Einstellungen. Apache bietet dafür das mitgelieferte Modul mod_md (seit Version 2.4.30, noch als experimentell gekennzeichnet), für NGINX gibt es seit 2025 ein natives ACME-Modul, das zunächst als Preview veröffentlicht wurde. Alternativ übernehmen externe Werkzeuge wie Certbot den Zertifikatsabruf.
Weitergabe der Client-Informationen
Da die Verbindung zum Backend vom Reverse-Proxy ausgeht, sieht der Backend-Server zunächst nur dessen IP-Adresse. Damit Anwendungen dennoch wissen, wer anfragt – etwa für Logs, Statistiken, Sicherheitsregeln oder standortbezogene Inhalte –, reicht der Proxy die ursprüngliche Client-IP, das verwendete Protokoll und den angefragten Host in HTTP-Headern weiter. Verbreitet ist der De-facto-Standard X-Forwarded-For (ergänzt um X-Forwarded-Proto und X-Forwarded-Host); standardisiert ist seit 2014 der Header Forwarded (RFC 7239). Aus Datenschutzgründen können Betreiber IP-Adressen auch gekürzt weitergeben oder protokollieren.
Header wie X-Forwarded-For können Clients selbst mitsenden und damit fälschen. Backend-Anwendungen sollten diese Angaben deshalb nur auswerten, wenn sie von einem vertrauenswürdigen Proxy stammen, und der Proxy sollte vom Client mitgeschickte Werte überschreiben oder bereinigen.
Kompression
Ein Reverse-Proxy kann Antworten der Backend-Server komprimieren, bevor er sie an den Client sendet. Das verringert die übertragene Datenmenge und beschleunigt den Seitenaufbau, vor allem bei textbasierten Inhalten wie HTML, CSS, JavaScript oder JSON. Bereits komprimierte Formate wie JPEG oder MP4 profitieren dagegen kaum. Welches Verfahren zum Einsatz kommt, handeln Browser und Server über den Header Accept-Encoding aus. Am weitesten verbreitet ist gzip, das in Webservern wie Apache oder NGINX über Module bereitsteht. Effizienter sind die neueren Verfahren Brotli und Zstandard (zstd), die aktuelle Browser wie Chrome, Edge und Firefox ebenfalls unterstützen. Je nach Software sind sie integriert oder per Zusatzmodul nachrüstbar.
Ein Content Delivery Network (CDN) ist im Kern ein weltweit verteiltes Netz von Reverse-Proxys mit Cache. Es liefert Inhalte von einem Standort in der Nähe der Nutzerinnen und Nutzer aus und fängt zugleich Lastspitzen und Angriffe ab, bevor sie den Ursprungsserver erreichen.
Reverse-Proxy, Load Balancer und API-Gateway: Wo liegt der Unterschied?
Die Begriffe überschneiden sich, da dieselbe Software oft mehrere Rollen übernimmt:
- Reverse-Proxy ist der Oberbegriff für eine Komponente, die Anfragen stellvertretend für Server entgegennimmt und weiterleitet – unabhängig davon, ob es dahinter einen oder viele Server gibt.
- Ein Load Balancer ist auf die Verteilung von Anfragen auf mehrere Server spezialisiert. Arbeitet er auf der Transportebene (Layer 4), verteilt er TCP- oder UDP-Verbindungen, ohne deren Inhalt auszuwerten. Ein Layer-7-Load-Balancer wertet dagegen HTTP-Inhalte wie Hostname, Pfad oder Cookies aus und ist damit zugleich ein Reverse-Proxy.
- Ein API-Gateway ist ein spezialisierter Reverse-Proxy für Programmierschnittstellen. Zusätzlich zur Weiterleitung übernimmt er Aufgaben wie Authentifizierung per API-Schlüssel oder Token, Ratenbegrenzung pro Kunde, Versionierung und Auswertung der API-Nutzung.
In Kubernetes-Clustern übernehmen Ingress-Controller die Rolle des Reverse-Proxys für die Dienste im Cluster. Für neue Installationen empfiehlt das Kubernetes-Projekt inzwischen die Gateway API anstelle der Ingress-API. Die Ingress-API ist eingefroren: Sie wird nicht mehr weiterentwickelt, bleibt aber als stabile Schnittstelle erhalten und soll nicht entfernt werden. Der verbreitete Controller Ingress NGINX wurde im November 2025 abgekündigt; seit März 2026 erhält er keine Updates und Sicherheitskorrekturen mehr. Er ist nicht zu verwechseln mit dem separat weiterentwickelten NGINX Ingress Controller von F5/NGINX.
Verbreitete Reverse-Proxy-Software
Für den Betrieb eines Reverse-Proxys stehen zahlreiche, überwiegend quelloffene Lösungen zur Verfügung:
- NGINX: Weit verbreiteter Webserver und Reverse-Proxy mit Load Balancing, Caching und TLS-Terminierung. HTTP/3 unterstützt NGINX seit Version 1.25.0 über ein experimentelles, optionales Modul.
- Apache HTTP Server: Mit den Modulen
mod_proxyundmod_proxy_balancerlässt sich der klassische Webserver als Reverse-Proxy und Load Balancer einsetzen. - HAProxy: Auf Load Balancing und hohe Verfügbarkeit spezialisierter Proxy für Layer 4 und Layer 7, der für hohe Last und Stabilität bekannt ist.
- Traefik: Für Container-Umgebungen wie Docker und Kubernetes entwickelter Reverse-Proxy, der neue Dienste automatisch erkennt und Zertifikate per ACME bezieht.
- Caddy: Webserver und Reverse-Proxy mit besonders einfacher Konfiguration und standardmäßig aktiviertem automatischem HTTPS.
- Envoy: Leistungsfähiger Proxy für Cloud-native Architekturen, der häufig als Grundlage für Service Meshes und API-Gateways dient.
In separaten Artikeln erklären wir Ihnen Schritt für Schritt, wie Sie einen NGINX-Reverse-Proxy bzw. einen Apache-Reverse-Proxy einrichten.
Reverse-Proxy in der Cloud betreiben
Wer Webanwendungen auf eigenen virtuellen Servern betreibt, kann den Reverse-Proxy als eigene Instanz vor die Anwendungsserver setzen. In einer Cloud-Infrastruktur wie der IONOS Compute Engine sieht ein typischer Aufbau so aus: Ein Server mit öffentlicher IP-Adresse betreibt die Proxy-Software, etwa NGINX oder HAProxy, und ist als einziges System aus dem Internet erreichbar. Die Anwendungs- und Datenbankserver hängen nur in einem privaten Netzwerk und sind aus dem Internet nicht direkt erreichbar. Steigt die Last, lassen sich zusätzliche Anwendungsserver hinter dem Proxy ergänzen, ohne dass sich an der öffentlichen Adresse etwas ändert. Um den Proxy selbst nicht zum einzigen Ausfallpunkt zu machen, sollten Sie bei geschäftskritischen Diensten mindestens zwei Proxy-Instanzen einplanen oder einen verwalteten Load-Balancer-Dienst des Cloud-Anbieters vorschalten.
Welche Nachteile und Risiken hat ein Reverse-Proxy?
So nützlich ein Reverse-Proxy ist, er bringt auch zusätzliche Komplexität mit sich:
- Single Point of Failure: Fällt ein einzelner Reverse-Proxy aus, sind alle Dienste dahinter nicht mehr erreichbar. Für hohe Verfügbarkeit sind daher redundante Proxys nötig, etwa mehrere Instanzen hinter einer gemeinsamen IP-Adresse.
- Zusätzliche Latenz: Jede Anfrage durchläuft eine weitere Station. In der Praxis ist der Aufschlag meist gering und wird durch Caching und Kompression oft mehr als ausgeglichen, bei schlecht dimensionierten Proxys kann er sich aber bemerkbar machen.
- Fehlkonfiguration: Falsche Regeln können Sicherheitslücken öffnen, etwa wenn interne Pfade oder Administrationsoberflächen ungewollt öffentlich erreichbar werden, personalisierte Seiten im Cache landen oder Backends ungeprüft weitergereichten Client-IPs vertrauen.
- Wartungsaufwand: Der Proxy ist ein exponiertes System und muss regelmäßig aktualisiert, überwacht und abgesichert werden. Zertifikate, Regeln und Weiterleitungen sind zu pflegen.
Reviewer
Christian Heldmaier
Christian Heldmaier ist ein erfahrener Online-Marketing- und SEO-Spezialist aus Karlsruhe. Seit Juli 2020 ist er als SEO Manager bei IONOS tätig.